蒸馏
模型工作区第四个 Tab。教师是大模型,学生是小模型。教师把知识传给学生。产物更小,更好部署。不是强化学习。
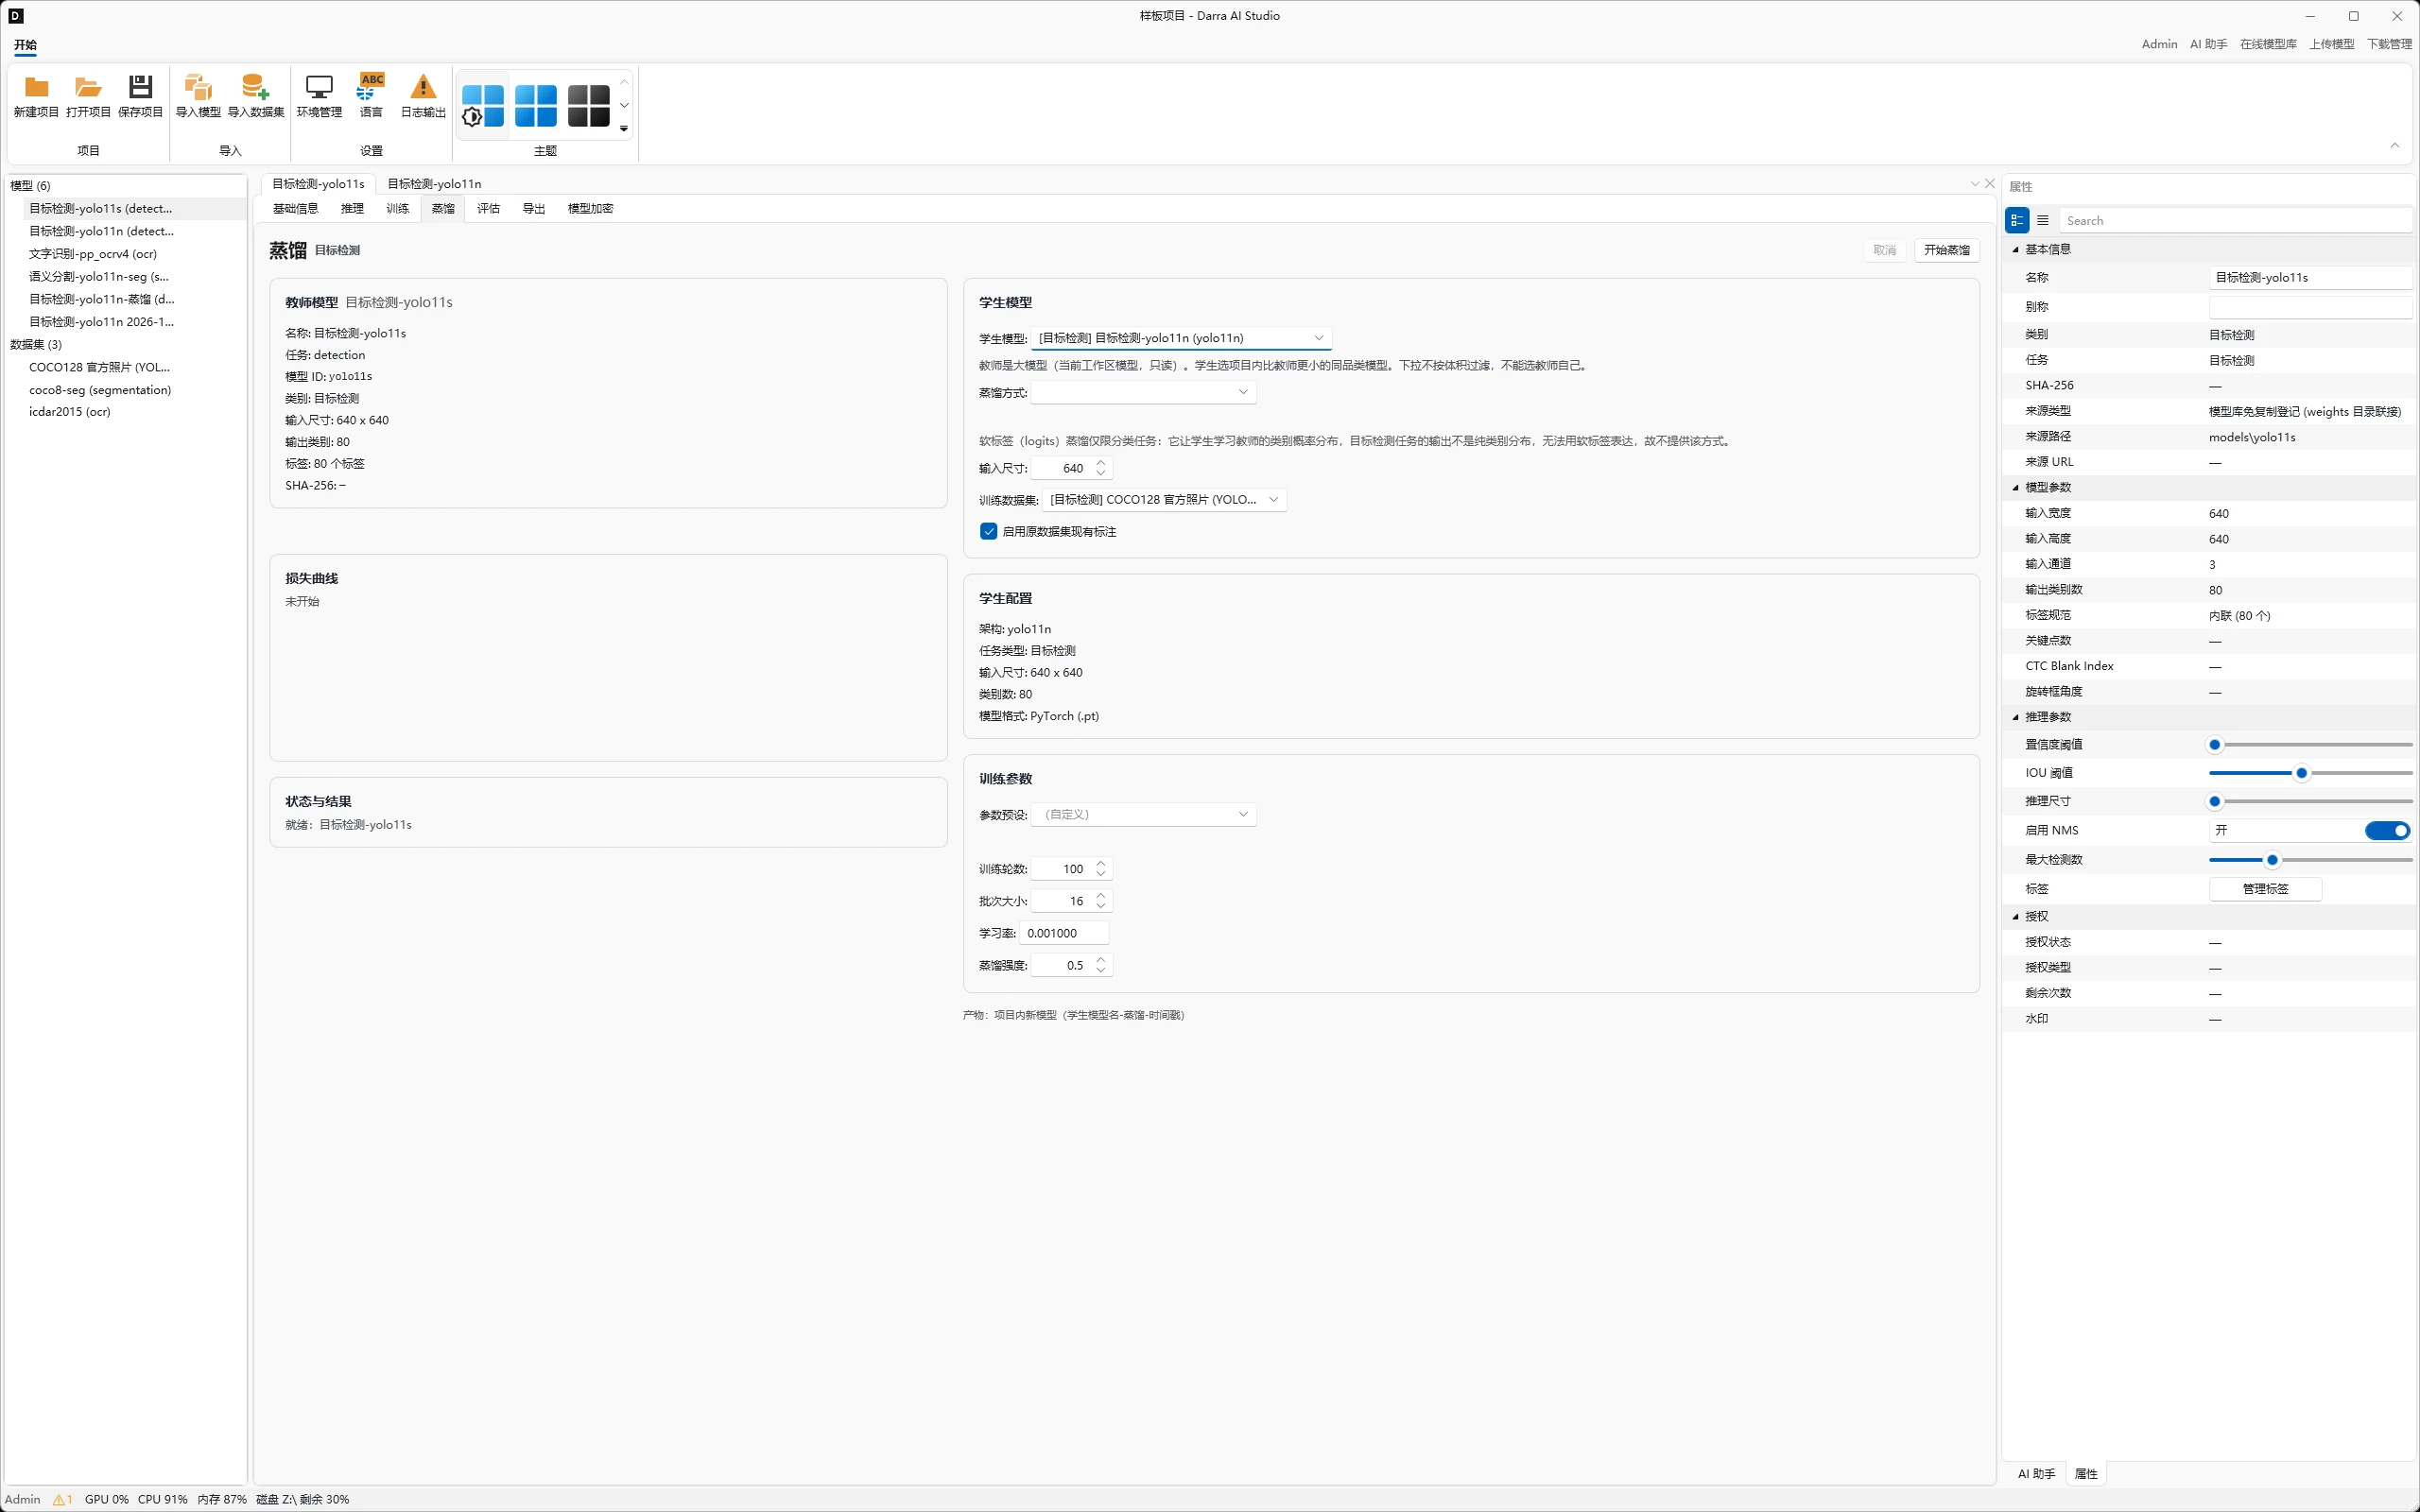
蒸馏页:左列教师模型只读信息(名称、任务、模型 ID、类别、输入尺寸、输出类别、标签、SHA-256)与任务支持横幅,右列学生模型、蒸馏方式、训练数据集与训练参数,按钮行「开始蒸馏」「取消」,页底蒸馏进度与蒸馏完成结果。
未载入教师时教师状态为「(未选中)」,页中空态。教师是当前工作区模型(大模型),从模型叶子右键 蒸馏 载入。项目里找不到该模型时状态为「模型 <模型 ID> 未找到」,按钮旁提示「该项目中没有找到该模型」。
教师与学生
教师是大模型,本页只读,不能更换。左列展示名称、任务、模型 ID、类别、输入尺寸、输出类别、标签、SHA-256。
学生是小模型,从「学生模型」下拉选。下拉只列同品类、可蒸馏的已导入模型,排除教师自己。下拉旁固定说明:「教师是大模型(当前工作区模型,只读)。学生选项目内比教师更小的同品类模型。下拉不按体积过滤,不能选教师自己。」
学生能进下拉的条件:
- 与教师同品类,品类识别不了的不进候选
- 非加密模型
- ultralytics 系须有 pt 权重文件;文字识别 / OCR文本检测须有 Paddle 目录或推理包
- 不是教师自己
下拉不按体积过滤,但开始前会校验学生不大于教师(参数量优先,缺失回退权重文件字节),比教师大时拒绝开始,同尺寸或更小放行。
未选学生点 开始蒸馏:「请先选择学生模型(项目内其它已导入模型,当前工作区模型是教师)」。选到教师自己:「学生不能是教师自己(当前工作区模型),请选择项目内另一份已导入模型」。品类对不上:「学生模型品类与教师不一致(学生: X, 教师: Y),请重新选择」。
选中学生后「学生配置」按模型真实信息只读刷新:架构、任务类型、输入尺寸、类别数、模型格式。这里不改模型结构。
加密模型不能当教师,也不能当学生。界面拒绝原文:「加密模型仅可用于推理,不能蒸馏;可先用其推理导出数据,再对数据二次训练」。单向加密与激活码:加密。
蒸馏方式
方式必须手选。空选点 开始蒸馏 报「选择蒸馏方式」,不会偷偷回落某一档。
| 方式 | 谁能用 | 教师权重 | 做什么 |
|---|---|---|---|
| 伪标签蒸馏(通用) | 全部支持品类 | pt 或 onnx 权重;OCR 为 Paddle 目录 | 教师产伪标签,学生微调 |
| 软标签蒸馏(分类) | 仅图像分类 | 必须 pt 权重 | 教师给类别概率,学生学习 |
| 特征对齐蒸馏(检测) | 仅目标检测 | 必须 pt 权重 | 学生中间层对齐教师特征 |
下拉按教师品类重建。图像分类教师多出「软标签蒸馏(分类)」。目标检测教师多出「特征对齐蒸馏(检测)」。其余只有伪标签。非分类教师显示真实原因:「软标签(logits)蒸馏仅限分类任务:它让学生学习教师的类别概率分布,<教师任务名>任务的输出不是纯类别分布,无法用软标签表达,故不提供该方式。」
选中后的说明原文:
- 伪标签蒸馏(通用) — 「教师给没标注的图写答案,学生用这些答案学。保证学生学的是教师的判断,不是自己抄自己。」OCR 教师改为「教师给图写字,学生用这些答案学。OCR 教师和学生都是另一份 Paddle 模型,不能蒸馏自己。」
- 软标签蒸馏(分类) — 「只适合分类。教师给出每个类别的把握程度,学生跟着学,比只学对错更细。」
- 特征对齐蒸馏(检测) — 「学生中间层去对齐教师中间层。两边结构要对得上,不能同一份权重自己对齐自己。」教师常驻显存,训练约慢 1.5 到 2 倍。
权重不匹配时的行内报错原文:
- 教师只有 onnx,却选软标签或特征对齐 — 「软标签/特征对齐蒸馏需要教师模型 .pt 权重(教师仅有 ONNX 权重时请改用伪标签蒸馏)」
- 教师没有可用权重 — 「教师模型没有可用的 .pt / .onnx 权重文件」;OCR 教师为「教师模型没有可用的 Paddle 模型 (目录/推理包)」
- 学生没有可用权重 — 「学生模型没有可用的 .pt 权重文件」;OCR 学生为「学生模型没有可用的 Paddle 模型 (目录/推理包)」
- 权重不是当前蒸馏栈能吃的格式 — 「教师权重不是 Ultralytics 格式,不能用当前蒸馏栈(YOLOv6/YOLOv7 官方包、facebook DETR、lyuwenyu RT-DETR .pth 需各自脚本)」;学生侧同句
支持的品类
页面接受的品类(支持横幅按此列表拼出):
- 目标检测
- 图像分类
- 语义分割
- 实例分割
- 姿态估计
- 旋转检测
- 深度估计
- 文字识别
- OCR文本检测
不在此列的品类出现横幅「该品类暂不支持蒸馏(当前支持目标检测 / 图像分类 / 语义分割 / 实例分割 / 姿态估计 / 旋转检测 / 深度估计 / 文字识别 / OCR文本检测),该模型任务为 <任务名>」,开始蒸馏 禁用,不假装能蒸。
支持时横幅为「支持任务:<同上列表>。当前教师任务:<任务名>,可开始蒸馏。」
文字识别 / OCR文本检测用 Paddle 训练环境,另受环境限制。横幅与按钮同一处:
- 探测中 — 「OCR 蒸馏需 Paddle 训练环境,正在探测...」,开始蒸馏 禁用。探测要一会儿,最坏约一分钟,请等结果,不要连点。
- 已就绪 — 「OCR 蒸馏环境已就绪(Paddle 训练栈可用),当前教师任务:<任务名>,可开始蒸馏。」
- 未就绪 — 「OCR 蒸馏需 Paddle 训练环境:<原因>」,开始蒸馏 禁用,横幅下出现 安装 Paddle 训练环境(安装中变为「正在安装 Paddle 环境...」)。装完自动重探。
伪标签数据
启用原数据集现有标注 — 默认勾选。检测 / 分割 / 实例分割 / 姿态 / 旋转检测把 GT 标签行与教师伪标签行写进同一标签文件,不去重;分类把位于类名子目录的图按 GT 归置,其余按教师预测归置;深度估计把 GT 深度图与教师深度图按蒸馏强度混合成同一张 16-bit 深度标签(强度越高越信教师),教师没深度输出就只用 GT 深度图。没勾就是纯教师伪标签。
未标注图像目录(教师将在此生成伪标签) — 只在「伪标签蒸馏(通用)」且教师非 OCR 时出现。空框提示「空着则只用训练数据集」。栏下说明原文:「仅伪标签蒸馏用。教师会在此目录的图上生成伪标签。空着也能开始:教师只对上面的训练数据集打伪标签;训练数据集也没有图可打时蒸馏会失败。」目录不存在会报「未标注图像目录不存在: <路径>」。池内一条伪标签都没有时只警告、不整轮失败;训练集加图片池整体一条都没有仍会失败。
蒸馏强度 — 0 到 1,步进 0.1,默认 0.5。悬停说明:「蒸馏强度 (0-1):伪标签档=采纳教师伪标签多少(越高越多);软标签档=软目标权重 α;特征对齐档=对齐损失权重」。伪标签档控制采纳多少教师标签(映射为教师伪标签置信度阈值:强度越高阈值越低,采纳越多);软标签档就是软目标权重 α,控制教师软目标在损失里的占比;特征对齐档控制对齐力度。本次打开 Studio 期间会记住上次改过的值。
OCR 蒸馏没有「未标注图像目录」。该项填了再开始会拒绝:「未标注图像目录仅 ultralytics 伪标签蒸馏支持,OCR 蒸馏请清空该项」。 ONNX 教师走伪标签档时为纯伪标签:勾了启用原数据集现有标注或填了未标注目录会拒绝「ONNX 教师蒸馏当前为纯伪标签模式:启用原数据集现有标注与未标注图像目录仅 .pt 教师支持」。 软标签档的温度 T 与软目标权重 α 都取自页面:温度 T 用「软标签温度 T」(页面可调,见下表),软目标权重 α 就是页面上的蒸馏强度(启用原数据集现有标注关时 α 不参与),两者都真进脚本。启用原数据集现有标注会决定损失里是否保留真标注交叉熵。
训练参数
| 项 | 范围 | 默认 |
|---|---|---|
| 输入尺寸 | 32 到 4096,步进 32 | 640 |
| 训练轮数 | 1 到 10000 | 100 |
| 批次大小 | 1 到 1024 | 16 |
| 学习率 | 大于 0 且不超过 1 | 0.001 |
| 蒸馏强度 | 0 到 1,步进 0.1 | 0.5 |
| 软标签温度 T | 大于 1 且不超过 20,步进 0.5 | 4 |
学习率失焦即时校验,非法时红框并提示「学习率必须是 (0, 1] 范围内的数字,例如 0.001」。
软标签温度 T 只在选了软标签蒸馏时出现。其余档折叠不显示。它软化教师类别分布,越大越平滑。非法时提示「软标签温度 T 必须是 (1, 20] 区间的数字,例如 4」。
参数预设 两档,空着显示「(自定义)」。套用预设会一次写入轮数、批次、学习率、蒸馏强度、是否启用原数据集现有标注。之后手改任一超参,预设自动回到自定义。
- 压缩体积 — 轮数 50,批次 32,学习率 0.002,蒸馏强度 0.85,不启用原数据集现有标注。说明:「少轮次、高蒸馏强度。请先选体积更小的学生模型。」
- 保精度 — 轮数 200,批次 8,学习率 0.0005,蒸馏强度 0.25,启用原数据集现有标注。说明:「多轮次、低蒸馏强度,并启用原数据集现有标注,尽量保住精度。」
OCR 教师时「输入尺寸」和「启用原数据集现有标注」禁用,Paddle 蒸馏用不到这两项。
操作
- 在模型叶子上右键 蒸馏,载入明文教师。
- 在「学生模型」选比教师小的同品类模型。
- 选「蒸馏方式」「训练数据集」,按需勾「启用原数据集现有标注」、填「未标注图像目录」。
- 填「训练参数」,或先选「参数预设」再微调。
- 点 开始蒸馏。页底「蒸馏进度」出现进度条和状态行,顺序大致是「正在检测训练设备...」「正在准备蒸馏脚本...」「正在运行蒸馏训练... (训练上限 1 小时, 超时自动中止)」「正在把蒸馏产物注册到项目模型库...」。
- 完成后出现「蒸馏完成」,项目内自动登记新模型。
数据集下拉按教师品类过滤。项格式为「[品类] 显示名 (数据集 ID)」。未选数据集报「选择数据集」。品类不一致报「数据集品类与教师模型不一致(数据集: X, 教师: Y),请重新选择」。ultralytics 系要在数据集目录或其上一级找到 data.yaml。找不到报「数据集目录中未找到 data.yaml」。类别数按教师、数据集 nc、学生三方核对。任一不一致会拒绝开始。例如「教师类别数 80 与数据集 nc=3 不一致, 无法蒸馏」。
取消与产物
取消 只停本轮。状态先「正在取消蒸馏...」,结束后「蒸馏已取消」。训练跑起来后的失败保留临时目录,并在状态里附路径。校验阶段失败的清掉空临时目录。成功完成后清掉临时目录。
产物不写到外部目录,完成后直接在项目内登记新模型:
- 显示名 = 学生显示名-蒸馏
- 权重文件名 = 学生名-蒸馏-yyyyMMdd-HHmmss 加原扩展名,同秒重名自动加序号
- 学生显示名取别称,其次显示名,最后模型 ID
- 新模型的父模型记教师,血缘记训练数据集
结果面板原文:「新模型已在项目内创建:<学生显示名>-蒸馏(ID: <新模型 ID>)」。页内固定提示:「产物:项目内新模型(学生模型名-蒸馏-时间戳)」。