导出
模型工作区第六个 Tab。把当前模型落到本地目录,或登记为项目内新模型。单模型页,模型由项目树或工作区打开后锁定载入,页内没有模型选择器,也不用刷新列表。本页只出开放格式;.darmodel 加密包走 加密 页签发。
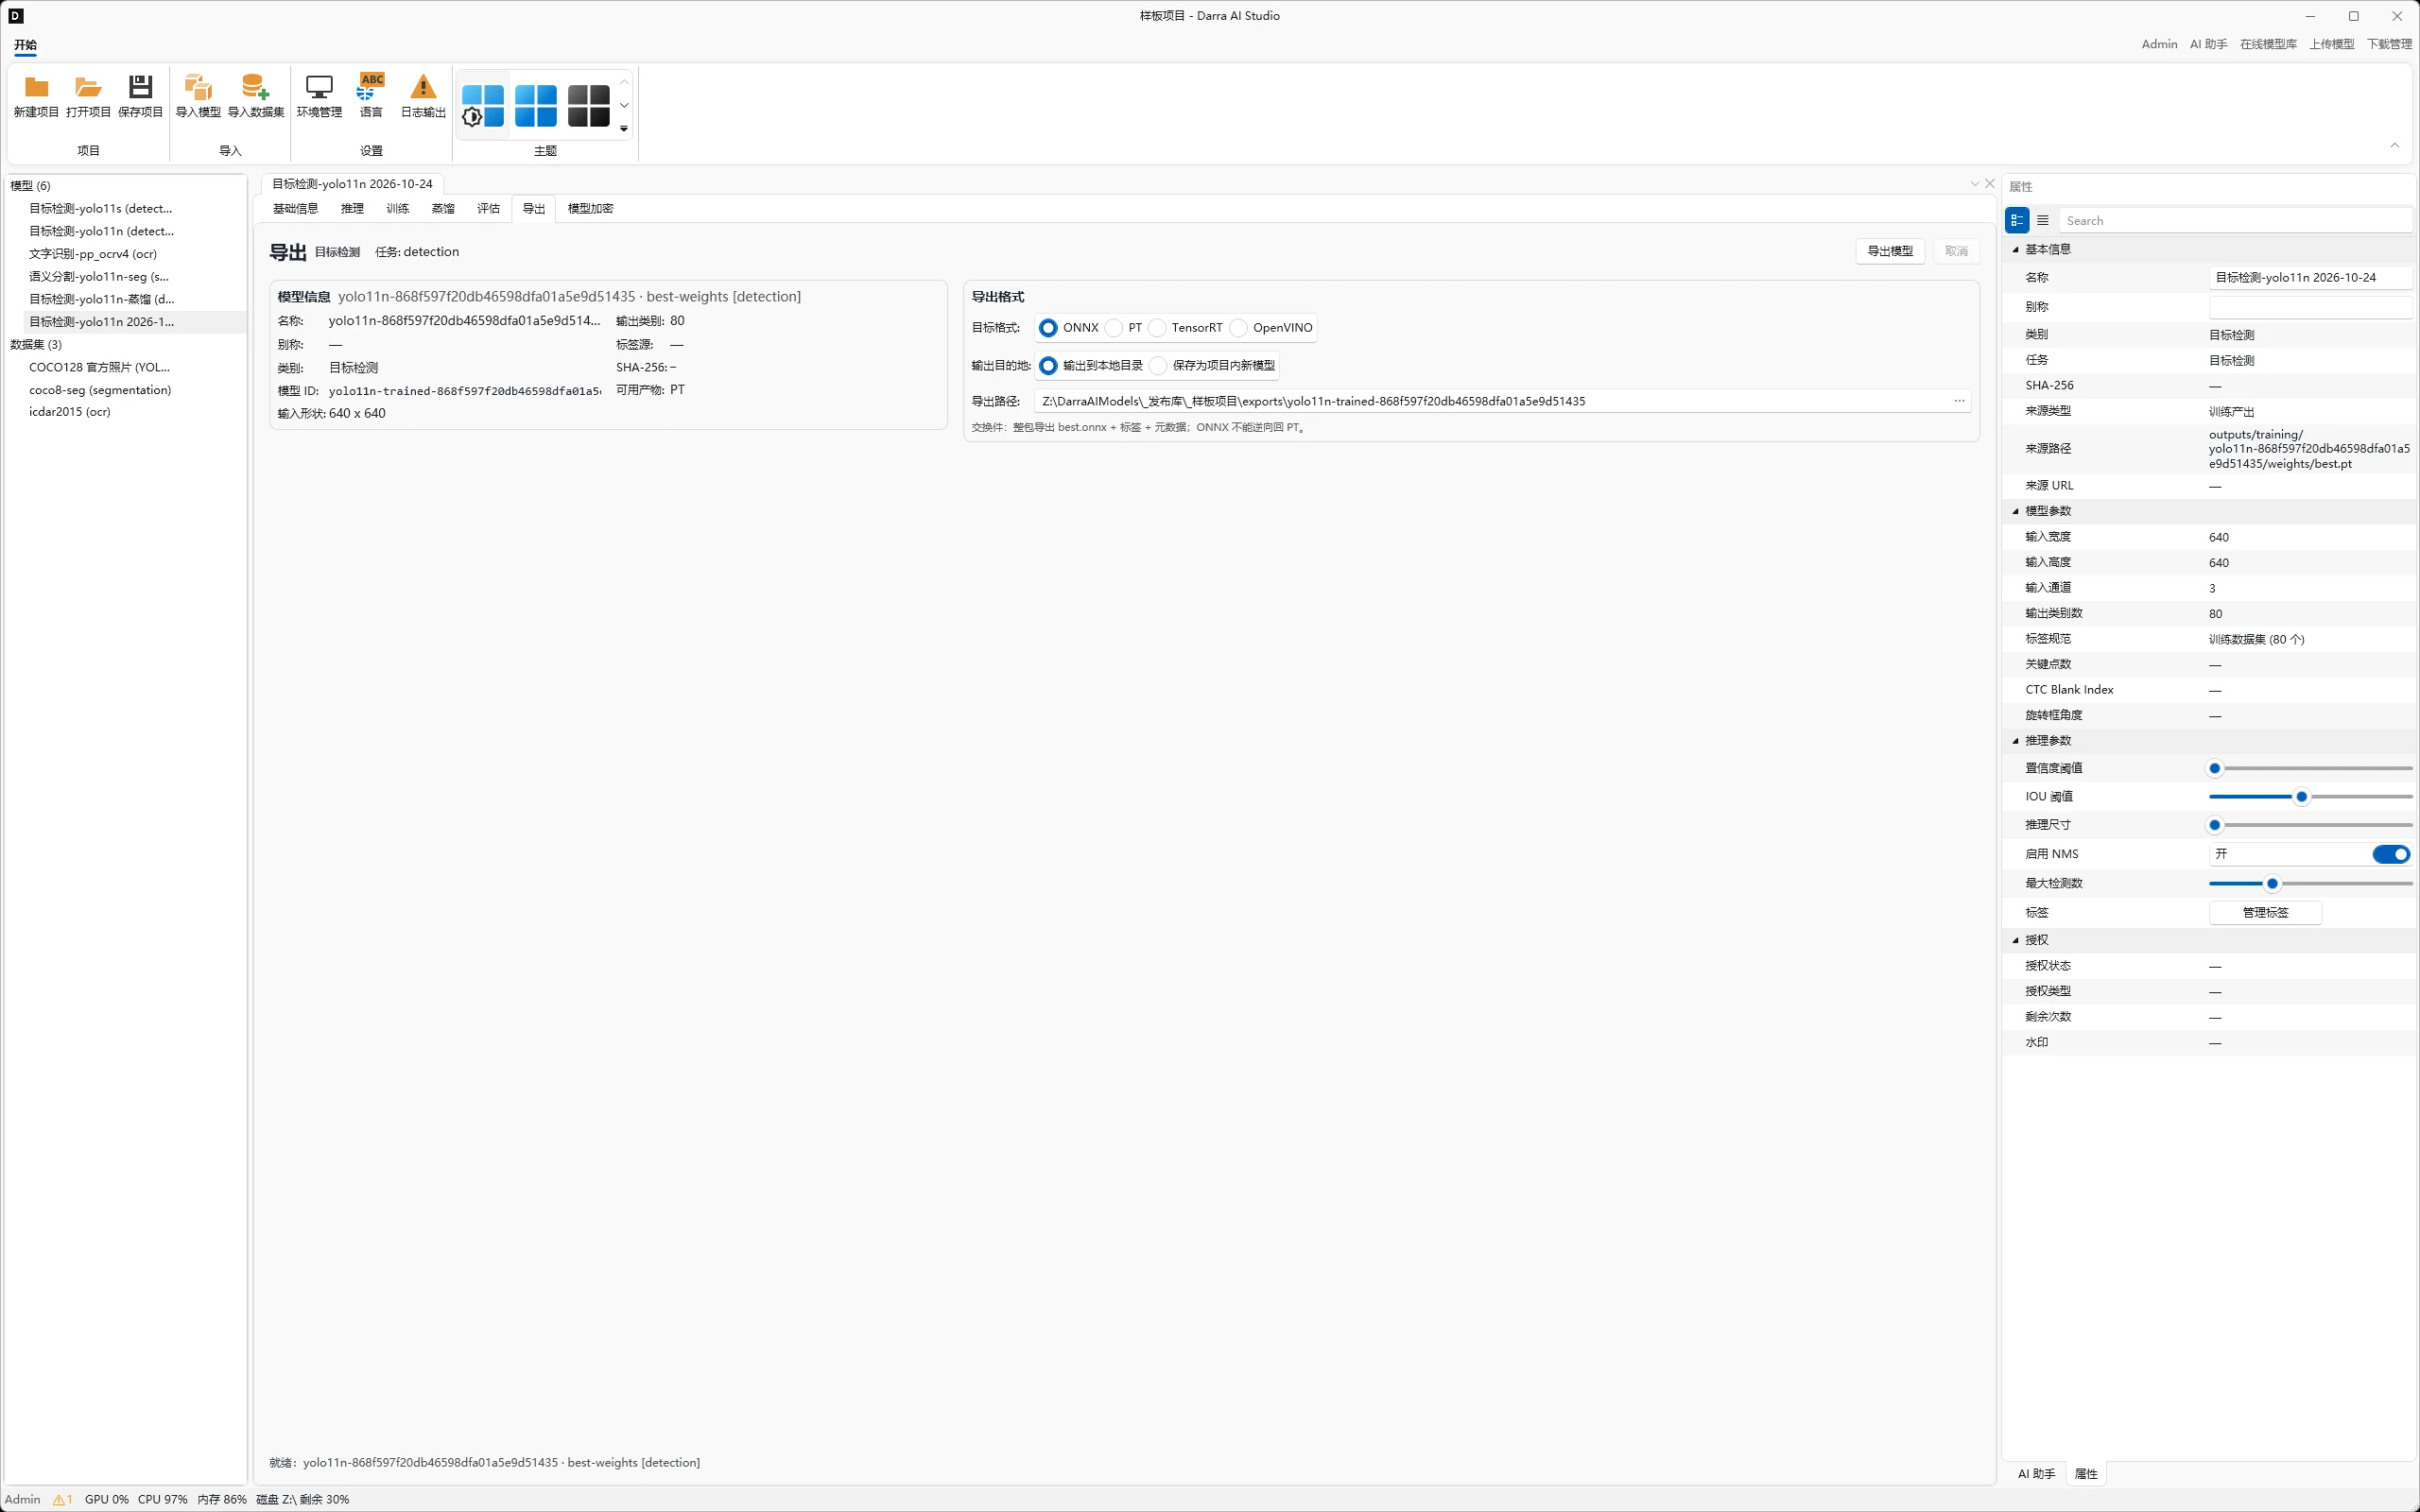
导出页:上部「模型信息」只读卡(名称、别称、类别、任务、模型 ID、输入形状、输出类别、标签源、SHA-256、可用产物),中部「导出格式」卡(目标格式横排单选、输出目的地、导出路径),下部「导出模型」「取消」两颗按钮,完成后出现「导出完成」卡与「打开输出目录」。
未加载模型时页内提示「未加载模型」。加载中按钮旁提示「正在扫描导出产物」;该模型没有权重文件时提示「该模型没有可导出的权重文件」,「导出模型」不可用。
导出就是格式转换:目标是什么格式就只出那个模型文件(TensorRT 出 .engine、OpenVINO 出 .xml+.bin、ONNX 出 .onnx、PT 出 .pt/.pth),不并附其它格式。PT/Paddle 转运行时格式时内部会经 ONNX 中转,但中间 ONNX 不落交付物。不能逆向转换,ONNX/engine/OpenVINO 回不去 PT。.pt/.pth 是训练格式,不是现场载荷。
两种产物形态
本页出的是开放导出产物;需要商业加密出包时走 加密 页签发,两条路互不覆盖:
| 形态 | 产物 | 现场怎么跑 | Darra AI SDK |
|---|---|---|---|
| 开放导出(本页) | .onnx、TensorRT .engine、OpenVINO .xml+.bin、PT | 客户手上已有的任意推理框架都能跑,如 ONNX Runtime、TensorRT、OpenVINO、DirectML、RKNN | 可选,不必装 |
| 单向加密(加密页签发) | .darmodel(加激活码离线推理) | 只能经 Darra AI SDK 推理;签发目录里没有明文权重文件 | 走 SDK;官方不解回明文 |
开放导出是产品开放性:可以不用我们的 SDK。模型加密是可选的,不是每个项目必过的关卡。常见做法是评估阶段用开放导出,出货再走加密签发。
SDK 不代装 NVIDIA 驱动或板端 NPU 驱动,只消费已部署的运行时包;驱动按板卡厂商说明在系统层安装。SDK 只做开包与推理(阻塞调用)。
模型信息
只读,不可改。缺字段显示破折号。
- 名称 — 当前导出项显示名
- 别称 — 项目登记的别称
- 类别 — 品类中文名
- 任务 — 任务类型
- 模型 ID — 项目内唯一 ID
- 输入形状 — 宽 x 高
- 输出类别 — 类别数
- 标签源 — 标签来源;无来源但项目里有标签表时显示「N 个标签」
- SHA-256 — 产物指纹
- 可用产物 — 产物扩展名大写,例如 ONNX、PT、PADDLE
目标格式
横排单选,默认选中 ONNX。ONNX、TensorRT、OpenVINO、CoreML 始终列出;仅当当前产物是 .pt 或 .pth 时多出一项 PT。导出页没有 RKNN 选项。
ONNX / PT 加「输出到本地目录」走整包导出(weights/ 下只带目标格式权重 + labels.txt + 元数据,不并附其它格式);TensorRT / OpenVINO / CoreML,或任意目标选「保存为项目内新模型」,走格式转换链(交付目录只落目标文件)。缺工具链就失败,不标成功,不拿源 ONNX 冒充引擎。
| 格式 | 何时出现 | 前置条件 | 产出 | 失败条件 |
|---|---|---|---|---|
| ONNX | 始终,默认选中 | 源为 PT、Paddle 或 ONNX | 本地整包导出 weights/best.onnx + labels.txt + 元数据(包内不附 PT/Paddle);项目内登记时产出 ONNX 并登记 | 源是 engine 或 OpenVINO 时按逆向转换拒绝;PT 非 ultralytics YOLO 结构时拒绝自动转 ONNX |
| PT | 仅当前产物是 .pt 或 .pth | 源必须是 PT | 整包导出原生权重 best.pt 或 best.pth(供继续训练或微调)+ 标签 + 元数据,不附 ONNX | 源不是 PT 时按逆向转换拒绝;项目内登记不会走 PT |
| TensorRT | 始终 | PT/Paddle 内部先经 ONNX 中转(中转文件不落交付物) | x86 + NVIDIA 的 TensorRT FP16 产物 .engine,交付目录只有它 | 缺 trtexec 且 Python OnnxToEngine.py 不可用;转不出可编译的中间模型;PT 非 ultralytics 结构不能编 |
| OpenVINO | 始终 | PT/Paddle 内部先经 ONNX 中转(中转文件不落交付物) | x86 + Intel 的 OpenVINO FP16 产物 .xml + .bin,交付目录只有这一对 | 本机缺 ovc/mo;转不出可编译的中间模型 |
| CoreML | 始终列出 | 转换矩阵要求 .pt 源 | 需 macOS 导出 | 「导出模型」禁用,行内提示 CoreML 只能在 macOS 上导出(本机是 Windows);无 .pt 源时矩阵提示走 ultralytics export |
PT / Paddle 编 TensorRT / OpenVINO 时内部先自动转 ONNX(中转文件只在临时目录,用完即删),再按目标编译,交付物只有目标格式文件;写完后回读验证一次,验证不过不标成功。矩阵拒绝原文:不能逆向转换。转换中心是 ONNX:PT/Paddle 转 ONNX;ONNX 转 engine/OpenVINO。
TensorRT 需要真实 trtexec 工具链。把官方 TensorRT zip 里的 bin\trtexec.exe 放到软件根 Env\toolchains\tensorrt\bin,或 pip install tensorrt-cu13;也可从右上角下载中心或 Ribbon「开始 → 环境管理」准备。缺 trtexec 会走 Python OnnxToEngine.py;两者都没有才失败,不生成假引擎。SDK 不代装工具链。
OpenVINO 要求本机已有 ovc 或 mo。Paddle 源按所选目标格式出文件(如 ONNX),Paddle 目录不再随包并附。
RKNN 有两层边界,与开放导出「产物可接任意推理框架」并列,不是同一件事:
- Windows 版 Studio 不提供 RKNN 转换。官方 rknn-toolkit2 不是 Windows 版,推理要瑞芯微 NPU 板。OCR 板端路径:导出 PP-OCRv4 的 ONNX(ppocrv4_det.onnx + ppocrv4_rec.onnx),到 Linux ARM64 板用 rknn-toolkit2 转两个 .rknn。不要用 Paddle tar / paddle-gpu。
- RKNN 运行时 Provider edge-rknn 只有 linux-arm64,且只推理、不带转换器。Windows / linux-x64 上点名 edge-rknn 会返回平台不支持。
整包里的 labels.txt
整包导出在包根写一份 labels.txt,跟权重一起交出去,用来把模型输出的类别下标对回类别名。格式只有一种:
- 编码 UTF-8,不带 BOM
- 一行一个类别名
- 行下标从 0 开始数,第几行就是 class_id 几(第 1 行 = class_id 0,第 2 行 = class_id 1,以此类推)
- 行首行尾空白读的时候会去掉;空行跳过;以
#开头的行当注释跳过
model.json 和 manifest.json 里有个 labelFormat 字段,值固定是 coco-yolo。这是历史遗留的字段名,不是格式说明:它既不是 COCO 的 JSON 标注,也不是 YOLO 的框标注 txt,值也不随版本变。认格式按上面几条认,别按字段名去猜,也别拿 COCO 或 YOLO 的规范来解析这个文件。
类别名取不到时 labels.txt 是空文件,不补占位名字,也不套通用类别表。名字对不上等于类别语义全错,宁可留空。
输出目的地
横排单选,默认「输出到本地目录」。
| 目的地 | 路径 | 路径可否改 |
|---|---|---|
| 输出到本地目录 | 默认 项目/exports/模型 ID(花括号占位) | 可改,点输入框浏览按钮选目录 |
| 保存为项目内新模型 | 固定 项目/exports/convert/模型 ID(花括号占位) | 路径框只读 |
保存为项目内新模型时,产物落到上述固定目录,并登记进项目模型列表;新模型显示名为「源名 (格式)」,保留源模型的任务与输入尺寸。非 ONNX 目标登记时保留源 PT 路径,转换产物的项目相对路径记在源路径字段,保证位置可追溯。
项目内登记时选 PT 无意义(原生权重已在项目内):目的地切到「保存为项目内新模型」会把 PT 自动切回 ONNX。若仍以 PT 发起登记,行内拒绝:PT 原生权重已在项目内,无需转换登记;要落盘请选「输出到本地目录」。
加密出包(不在本页)
导出页只出开放格式,不出加密包,也没有加密勾选与页内密码行。需要商业出包时走 加密 页签发 .darmodel(仅可推理,每次运行需密码),激活码同页生成,生成后只显示一次。
加密档名与 加密 页同一套:
- 一级加密 · 标准
- 三级加密 · 切片
各档同一套包格式与授权锁,差别在模型在盘上、在内存里的形态,以及加载那一次的工作量:
- 一级:加载时解出整份模型交给推理框架,随即抹掉我们手上的明文缓冲;额外的工作只发生在打开模型那一次。代价是加载时解密一次、抹一次缓冲;推理期不解密模型。
- 三级:图权分离,图结构与权重分开存,落盘时权重不在模型文件里,防静态抽取。加载期仍是整块解密,内存中仍有明文,峰值明文不小。代价是加载期整块解密建会话;推理期不解密模型。三级只支持 ONNX 与已剥离的 TensorRT 引擎(全量引擎当三级会拒收)。三级推理已在 CPU 与 CUDA 跑通:CPU 上 47 个发布库模型里 43 个切片成功、4 个因无可切片权重跳过,推理耗时与明文持平(100–101%);CUDA 上 3 个模型推理耗时同样与明文持平(98–101%)。DirectML、TensorRT、OpenVINO 的三级推理尚未验证。一级已验证 CPU / CUDA / DirectML / OpenVINO。
旧版加固包仍可打开,但该档位已下线,新包不提供。历史实现仅 DirectML 生效、8 字节钥、推理期块是明文,非加密级保护;CPU/CUDA/TensorRT/OpenVINO 路径与一级逐字节相同。
不把未实测毫秒数写成规格。
.darmodel 加密出包是可选的、单向的;官方不解回明文。现场创建 AiClient 后 Open → InferFile → Close(C)。模型指纹只用于标识这一份包(不提供泄露溯源)。不宣称绝对安全。拿到包和激活码的买家可离线解出模型;要真正防转发需在线激活或 TPM 封装,当前版本不提供。
快速开始
- 从项目树双击模型叶子,或在模型叶子右键选「导出」,打开模型工作区导出 Tab。
- 核对「模型信息」只读字段。
- 在「导出格式」选目标格式。说明文字随选中项更新。
- 选输出目的地。本地目录可点浏览按钮改导出路径;项目内登记的路径固定只读。
- 需要商业出包时去 加密 页签发 .darmodel,本页不加密。
- 点「导出模型」。页底进度条在导出时显示,空闲不占高度。
- 完成后出现「导出完成」与目标文件路径,点「打开输出目录」用资源管理器打开。
导出中「取消」可用。点「取消」后提示「正在取消导出…」并停用取消按钮,本轮停下;按钮旁出现「导出已取消」或「转换已取消」。失败、取消都不写半假产物。
参数不合法时按钮旁行内报错,常见原文:
- 选择导出格式
- 选择输出目录
- PT 原生权重已在项目内,无需转换登记;要落盘请选「输出到本地目录」
- CoreML 只能在 macOS 上导出(本机是 Windows)。
- 不能逆向转换。转换中心是 ONNX:PT/Paddle 转 ONNX;ONNX 转 engine/OpenVINO。